El factor de seguridad se calcula a partir de parámetros que solo se conocen de forma aproximada. En un análisis probabilístico, algunos de ellos se describen como variables aleatorias y se muestrean muchas veces, con lo que se obtiene cómo varía el factor de seguridad: su media y su dispersión, la probabilidad de que resulte inferior a uno y un índice de fiabilidad. El análisis de sensibilidad, que hace variar los parámetros de uno en uno, se trata al final del capítulo.
3.11.1Variables aleatorias#
Una variable aleatoria identifica un dato de entrada del modelo (qué parámetro de qué objeto) y le asigna una distribución. Pueden hacerse aleatorios los datos de entrada siguientes:
- cualquier parámetro del modelo de resistencia de un material: y , y los parámetros de todos los modelos no lineales (Sección 3.5);
- el peso específico y el peso específico saturado de un material, así como su , su presión intersticial constante, su y su valor de entrada de aire;
- las propiedades hidráulicas de los materiales que las tienen: permeabilidad saturada, relación y ángulo de anisotropía, parámetros de las funciones no saturadas, contenidos de agua saturado y residual, y almacenamiento específico;
- la magnitud de las cargas distribuidas y de las lineales;
- los coeficientes sísmicos y ;
- la posición del nivel freático, definida como un desplazamiento vertical de media nula que desplaza todos los vértices del nivel freático en la misma cantidad.
Cada variable se define con una media , que parte del valor actual del parámetro, una desviación típica y un mínimo y un máximo relativos, es decir, distancias por debajo y por encima de la media. La variable se trunca entre los límites
que es la forma habitual de expresar una incertidumbre («10 kPa, más o menos 4»). Si la distancia mínima es menor que la media, además se garantiza que toda muestra sea físicamente posible: un ángulo de rozamiento truncado así nunca resulta negativo. Una variable nueva parte con igual al 10 % de su media y con un margen del 30 % de la media a cada lado, o de 0.1 y 0.3 en valor absoluto si la media es cero. Una variable cuyo margen es nulo, o una variable normal o lognormal sin desviación típica, no es aleatoria y conserva su media; las distribuciones normal, lognormal, beta y gamma requieren todas una desviación típica positiva.
Las variables aleatorias se definen en Statistics → Random Variables, donde se enumeran todos los parámetros del modelo que pueden muestrearse y se representa la densidad de la variable que se está editando. Cada muestra se escribe en una copia del proyecto, por lo que un cálculo estadístico nunca modifica el modelo. Cuando una definición ya no corresponde al modelo (por ejemplo, porque se ha eliminado después un material), el cálculo señala la variable afectada, en lugar de omitirla sin avisar.
Código: ogr_core/statistics/random_variables.py3.11.2Distribuciones#
Se dispone de siete distribuciones. La Tabla 3.11.1 da la densidad de cada una y cómo se obtienen sus parámetros a partir de los datos de entrada; y son los límites de la Ec. (3.11.1).
| Distribución | Densidad | Parámetros |
|---|---|---|
| Normal | , los valores introducidos | |
| Uniforme | en | solo los límites; no se usa |
| Triangular | para , para | vértice ; no se usa |
| Beta | en | , , , , |
| Exponencial | , | ; no se usa |
| Lognormal | , | |
| Gamma | , |
Las distribuciones lognormal y gamma se parametrizan con la media y la desviación típica de la propia variable, que son los datos que maneja el usuario, y no con las de su logaritmo ni con los parámetros de forma y de escala. La distribución beta se ajusta por momentos en , de modo que conserva y siempre que esa desviación típica sea alcanzable en el intervalo (los parámetros de forma no bajan de ). En las distribuciones uniforme y triangular, la media solo sirve para situar los límites y, en la triangular, el vértice: si el intervalo es asimétrico, la media de las muestras no coincide con . Con , y , las muestras uniformes tienen una media de 12 y las triangulares de 11.33 (Figura 3.11.1).
3.11.3Truncamiento#
El truncamiento se impone invirtiendo la función de distribución acumulada, y no por rechazo de muestras. Un valor uniforme se traslada al tramo de la distribución acumulada comprendido entre los límites y luego se invierte:
donde
- función de distribución acumulada de la distribución sin truncar, y su inversa
Toda muestra queda dentro de (además se recorta a ese intervalo para evitar errores de redondeo), la densidad dentro del intervalo es y, a diferencia del rechazo, la transformación no altera la estratificación del muestreo por hipercubo latino: cada estrato de sigue dando exactamente una muestra.
3.11.4Muestreo#
En el muestreo de Monte Carlo (Metropolis y Ulam, 1949) cada valor uniforme se extrae de forma independiente. El muestreo por hipercubo latino (McKay, Beckman y Conover, 1979) divide en estratos iguales y extrae un valor en cada uno,
y después los baraja de forma independiente para cada variable. De este modo, cada variable recorre toda su distribución de manera uniforme con muestras, mientras que el emparejamiento entre variables sigue siendo aleatorio (Figura 3.11.2). Una opción permite, en cambio, compartir una misma estratificación entre todas las variables: la muestra cae entonces en el mismo estrato de todas ellas, y todas se mueven juntas. Eso responde a otra pregunta (qué ocurre si todos los parámetros son desfavorables a la vez) y suele aumentar la dispersión del factor de seguridad; no tiene sentido en el muestreo de Monte Carlo, que no tiene estratos.
Los números aleatorios pueden generarse de forma pseudoaleatoria, a partir de una semilla, de modo que el mismo modelo con la misma semilla da las mismas muestras, o de forma aleatoria, con la semilla tomada del reloj, lo que permite comprobar que una conclusión no depende de una semilla concreta.
3.11.5Correlación entre cohesión y ángulo de rozamiento#
Una variable puede declararse correlacionada con otra mediante un coeficiente comprendido entre −1 y 1. El uso previsto es el de la cohesión y el ángulo de rozamiento de un material de Mohr-Coulomb, en el que lo habitual es un coeficiente negativo. OGR Slip2D impone la correlación después del muestreo, reordenando los valores según el procedimiento de Iman y Conover (1982): las dos variables conservan exactamente los valores muestreados y, por tanto, sus distribuciones; solo cambia el emparejamiento. Si es el rango del -ésimo valor de la variable de referencia entre sus valores,
donde
- inversa de la función de distribución normal estándar
- números aleatorios normales estándar independientes
y los valores ordenados de la variable correlacionada se reasignan de modo que sus rangos sigan los de . Trabajar con las puntuaciones normales de los rangos, en lugar de con los rangos mismos, es lo que acerca el coeficiente obtenido al solicitado, con el que solo coincide de forma aproximada. Las puntuaciones empleadas son , una variante de las puntuaciones de van der Waerden de Iman y Conover; ambas se diferencian solo en la posición de representación.
El análisis se configura en Analysis → Project Settings → Statistics, donde se fijan Probabilistic analysis, Analysis type (Global Minimum por defecto), Sampling method (Monte Carlo por defecto) y Number of samples (1000), y en Random Numbers, donde se fijan Generation (pseudoaleatoria por defecto), Seed (10116) y la estratificación compartida del hipercubo latino (desactivada). La misma semilla rige también las búsquedas que generan superficies al azar. La correlación de una variable se define junto a su distribución, en Statistics → Random Variables.
Código: ogr_core/statistics/distributions.py · ogr_core/project/settings.py3.11.6Mínimo global y talud completo#
El tipo mínimo global, que es el que se aplica por defecto, ejecuta primero el análisis determinista para localizar la superficie crítica de cada método y después vuelve a evaluar esa superficie para cada muestra. El círculo (o la polilínea) es fijo, pero cada muestra determina sobre él su propia masa deslizante, con los ajustes de búsqueda del análisis determinista, de modo que cada muestra requiere un cálculo de equilibrio límite por método. Cada método conserva su propia superficie crítica.
El tipo talud completo repite la búsqueda entera para cada muestra, por lo que no se presupone la posición de la superficie crítica: el factor de seguridad de una muestra es el mínimo que encuentra su búsqueda. Esto supone una búsqueda completa por muestra. Además, el cálculo acumula los factores de todas las superficies que evalúa y da la superficie probabilística crítica, que es la de mayor probabilidad de rotura entre las evaluadas al menos cinco veces (si hay empate, la de menor índice de fiabilidad) y no tiene por qué coincidir con la superficie crítica determinista. Las superficies se identifican de una muestra a otra por su geometría, redondeada a 0.5 m.
En ambos tipos, una muestra cuya superficie no puede resolverse, o es inadmisible (Sección 3.3), carece de factor de seguridad: se excluye de los estadísticos y se contabiliza según la causa, y el cálculo avisa de la pérdida (en el mínimo global, cuando se pierde más del 20 % de las muestras).
Si hay una norma de diseño activa, cada muestra se prepara igual que en el análisis determinista: los valores muestreados se escriben en una copia del modelo y a esa copia se le aplican después los coeficientes parciales, de modo que los estadísticos describen el factor de sobredimensionamiento y su probabilidad de ser inferior a uno (Sección 3.12).
Código: ogr_core/statistics/probabilistic.py · ogr_slip2d/analysis_runner.py3.11.7Probabilidad de rotura e índice de fiabilidad#
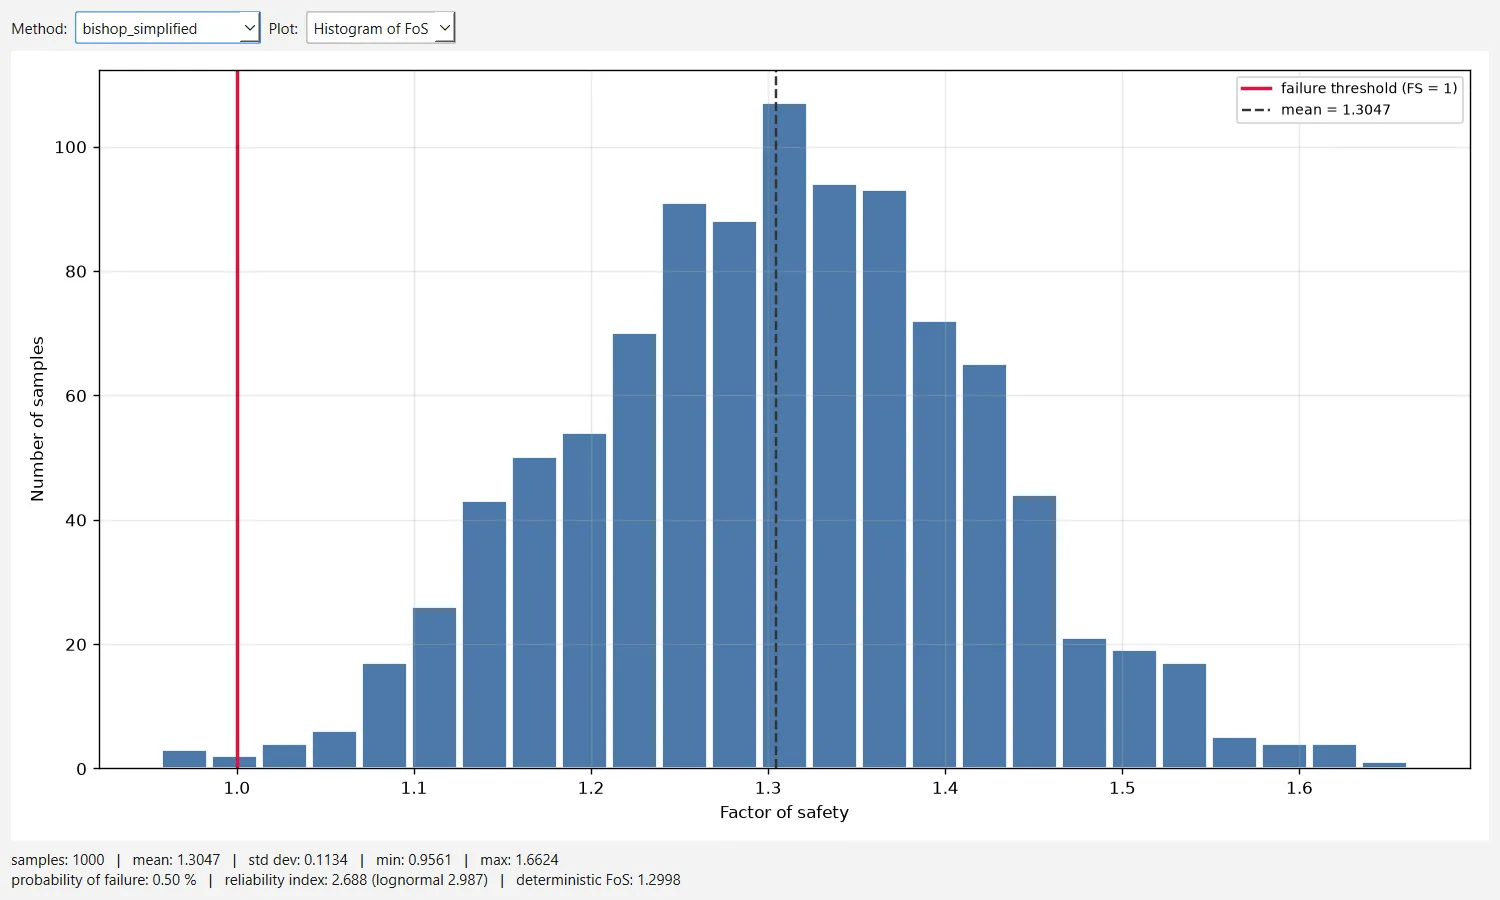
La probabilidad de rotura es la fracción de muestras válidas cuyo factor de seguridad es inferior a uno:
donde
- número de muestras con un factor de seguridad válido y admisible
- número de ellas con estrictamente inferior a uno
El índice de fiabilidad mide la distancia entre el factor de seguridad medio y la rotura, expresada en desviaciones típicas (Cornell, 1969). OGR Slip2D lo da en dos formas:
donde
- media y desviación típica de los factores de seguridad muestreados (la desviación típica, con en el denominador)
- los mismos estadísticos de , calculados con los factores de seguridad positivos
La forma lognormal aplica la misma definición a , para el que la rotura corresponde a ; suele describir mejor el factor de seguridad, ya que este no puede ser negativo. Un muestreo sin dispersión da . La probabilidad de rotura, por sí misma, no presupone ninguna forma para la distribución de .
3.11.8Convergencia#
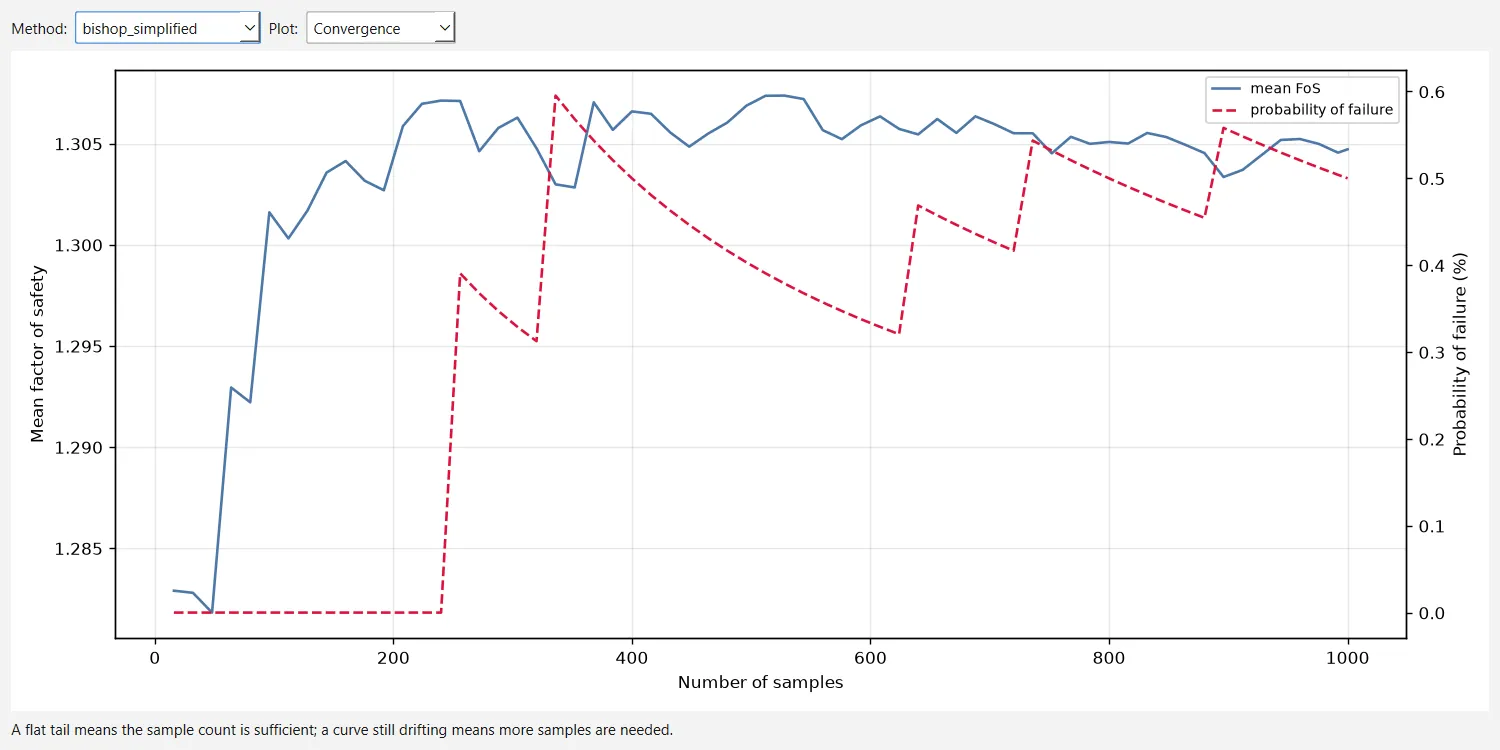
Las estimaciones se estabilizan a medida que aumenta el número de muestras. OGR Slip2D registra el factor de seguridad medio acumulado y la probabilidad de rotura acumulada a lo largo de la secuencia de muestras, en unos 50 puntos (cada muestras y en la última). Con ellos se dibuja el gráfico de convergencia de un cálculo: si la media o la probabilidad siguen cambiando en la última muestra, hacen falta más muestras. Una probabilidad de rotura pequeña exige muchas muestras para poder estimarse, pues se trata de un recuento de sucesos raros.
3.11.9Análisis de sensibilidad#
El análisis de sensibilidad no es probabilístico: la forma de las distribuciones no interviene y solo se usan el mínimo y el máximo de cada variable. Cada variable se hace variar, de una en una, a lo largo de su intervalo, dividido en subintervalos iguales,
y en cada valor se recalcula el factor de seguridad sobre la superficie crítica de cada método, con todos los demás parámetros en los valores del modelo determinista. Con el valor por defecto resultan 51 evaluaciones por variable y método. Las variables se ordenan por la amplitud de variación del factor de seguridad en su intervalo; para cada una, el programa da además el punto en que la curva corta un factor de seguridad objetivo, por interpolación lineal entre los dos valores que lo acotan, y el eje horizontal puede expresarse como porcentaje de cada intervalo, de modo que variables con unidades distintas compartan un mismo gráfico. Los valores para los que la superficie no tiene un factor de seguridad admisible no se representan en la curva.
Sensitivity analysis y el número de Sensitivity intervals (50 por defecto) se encuentran en la página Analysis → Project Settings → Statistics. El análisis recorre las mismas variables aleatorias que el probabilístico y, si hay una norma de diseño activa, a cada modelo se le aplican los coeficientes parciales igual que al determinista.
Código: ogr_core/statistics/sensitivity.py3.11.10Referencias#
- Cornell, C.A. (1969). A probability-based structural code. Journal of the American Concrete Institute, 66(12), 974–985.
- Iman, R.L. & Conover, W.J. (1982). A distribution-free approach to inducing rank correlation among input variables. Communications in Statistics — Simulation and Computation, 11(3), 311–334.
- McKay, M.D., Beckman, R.J. & Conover, W.J. (1979). A comparison of three methods for selecting values of input variables in the analysis of output from a computer code. Technometrics, 21(2), 239–245.
- Metropolis, N. & Ulam, S. (1949). The Monte Carlo method. Journal of the American Statistical Association, 44(247), 335–341.