Un análisis probabilístico toma como variables aleatorias algunos datos de entrada del modelo, genera muestras de ellas y recalcula el factor de seguridad con cada muestra, de lo que resultan la distribución del factor de seguridad, la probabilidad de rotura y el índice de fiabilidad. El análisis de sensibilidad, en cambio, hace variar un solo dato cada vez dentro de su intervalo. Ambos se configuran en Project Settings y en el menú Statistics, y sus resultados se leen en la ventana Statistics; la base estadística está en la Sección 3.11.
En esta versión el cálculo no puede completarse desde el menú de la ventana (véase la Sección 2.10.4). Aun así, los ajustes que se describen a continuación son los que usa el análisis cuando se ejecuta mediante el servidor MCP o la API de Python.
2.10.1Activación del análisis#
Los dos análisis se activan en Analysis → Project Settings → Statistics. Mientras no se marque uno de ellos, los comandos del menú Statistics aparecen en gris. Random Variables… se habilita en primer lugar, Compute Statistics cuando hay al menos una variable aleatoria definida y Show Statistics cuando hay resultados que mostrar.
| Campo | Qué hace | Por defecto |
|---|---|---|
| Probabilistic analysis | Muestrea las variables aleatorias y recalcula el factor de seguridad con cada muestra. | desactivado |
| Sensitivity analysis | Hace un barrido de cada variable aleatoria dentro de su intervalo, de una en una. | desactivado |
| Analysis type | Global Minimum evalúa cada muestra sobre la superficie crítica del análisis determinista. Overall Slope repite toda la búsqueda con cada muestra, de modo que la posición de la superficie crítica no se da por fija; es mucho más lento. | Global Minimum |
| Sampling method | Monte Carlo o Latin Hypercube. | Monte Carlo |
| Number of samples | N (de 1 a 1 000 000). | 1000 |
| Sensitivity intervals | Intervalos iguales en que se divide el margen de variación de cada variable en el barrido de sensibilidad (de 2 a 500); se evalúan intervalos + 1 valores. | 50 |
2.10.2Variables aleatorias#
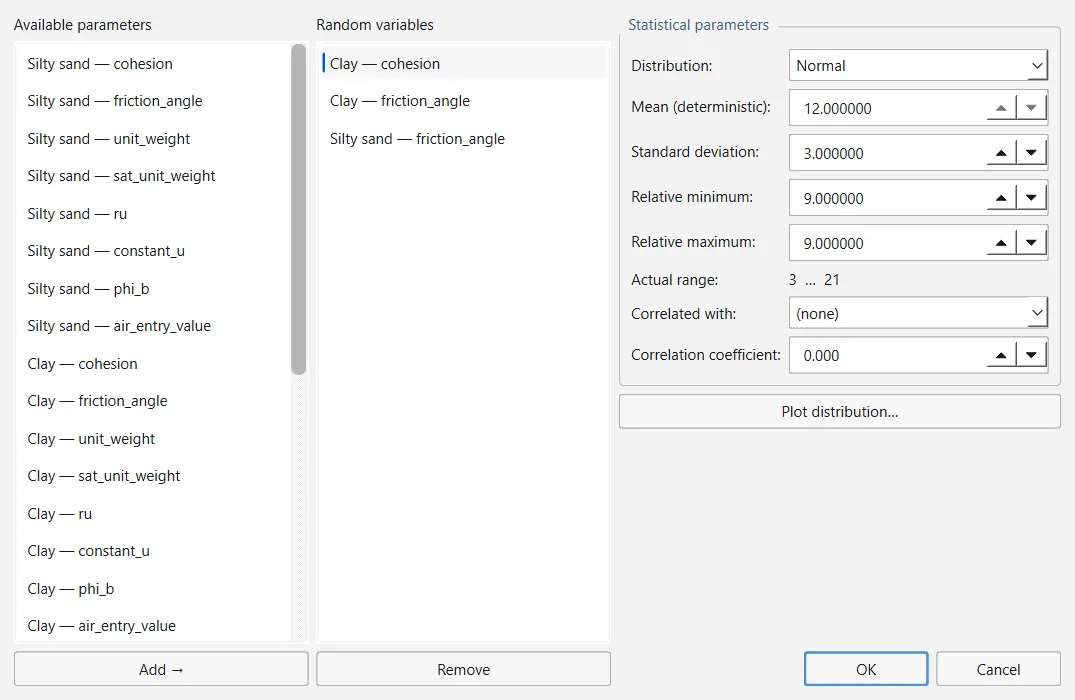
Statistics → Random Variables… abre un diálogo de tres columnas. En Available parameters figuran todos los datos de entrada del modelo que pueden hacerse aleatorios; selecciona uno y pulsa Add → para pasarlo a Random variables (con Remove vuelve a la lista). La distribución de la variable seleccionada se edita a la derecha. Los parámetros disponibles son:
- los parámetros del modelo de resistencia de cada material (cohesión, ángulo de rozamiento y los parámetros de los demás modelos);
- el peso específico y el peso específico saturado de cada material, ru, la presión intersticial constante, el ángulo φb de resistencia al corte no saturado y el valor de entrada de aire;
- los parámetros hidráulicos de los materiales que los tienen;
- los parámetros de cada soporte;
- las magnitudes de las cargas distribuidas y lineales;
- los coeficientes sísmicos kh y kv;
- un desplazamiento vertical del nivel freático, si el modelo tiene alguno.
| Campo | Qué hace |
|---|---|
| Distribution | Normal, Uniform, Triangular, Beta, Exponential, Lognormal o Gamma. |
| Mean (deterministic) | El valor del modelo; es de solo lectura. Para cambiar la media hay que cambiar el modelo. |
| Standard deviation | La emplean las distribuciones Normal, Lognormal, Beta y Gamma; en las demás aparece en gris. |
| Relative minimum, Relative maximum | Cuánto puede bajar y subir la variable respecto de la media. Actual range muestra el resultado, de la media − mínimo relativo a la media + máximo relativo. |
| Correlated with, Correlation coefficient | Otra variable aleatoria del modelo y un coeficiente entre −1 y 1. Lo habitual es un coeficiente negativo entre la cohesión y el ángulo de rozamiento. |
Una variable recién añadida es de tipo Normal, con una desviación típica del 10 % de su media y límites relativos del 30 % de la media a cada lado (0.1 y 0.3 si la media es cero, como ocurre con un coeficiente sísmico o con el desplazamiento del nivel freático). Plot distribution… dibuja la densidad de probabilidad que se va a muestrear, con la media marcada.
Las distribuciones se truncan a su intervalo real. Las muestras se obtienen invirtiendo la distribución entre los dos límites, de modo que ningún valor queda fuera de ellos y los estratos del hipercubo latino se mantienen tras el truncamiento. La correlación indicada se impone reordenando los rangos de la segunda variable, con lo que ambas distribuciones marginales no se alteran (Iman y Conover, 1982). Cada muestra se aplica a una copia del modelo, así que el cálculo no modifica tu proyecto.
Código: ogr_core/statistics/distributions.py · ogr_core/statistics/random_variables.py2.10.3Muestreo y semilla#
Monte Carlo genera cada muestra de forma independiente. Latin Hypercube divide el intervalo de probabilidad de cada variable en N estratos y toma una muestra de cada uno, de modo que suele bastar con menos muestras para obtener la misma precisión (McKay, Beckman y Conover, 1979).
Los números aleatorios se ajustan en Analysis → Project Settings → Random Numbers:
- Generation: Pseudo-random (por defecto) es reproducible, pues la misma Seed (10116 por defecto) da siempre las mismas muestras y, por tanto, el mismo resultado. Random toma la semilla del reloj, de modo que cada ejecución difiere de la anterior, lo que sirve para comprobar que una conclusión no es un artefacto de una semilla concreta. Con Random, el cuadro Seed aparece en gris.
- Share one Latin Hypercube stratification across variables (desactivado): la muestra i cae entonces en el mismo estrato de todas las variables, de modo que todas resultan desfavorables a la vez. Responde a una pregunta distinta de la del caso independiente y suele aumentar la dispersión. Con Monte Carlo no tiene ningún efecto.
Esa misma página fija también la semilla de las búsquedas aleatorias de superficies de rotura (Sección 2.7).
2.10.4Cálculo de las estadísticas#
Statistics → Compute Statistics ejecuta primero el análisis determinista, con cada método activado y su búsqueda, para hallar la superficie crítica de cada método. Después:
- un análisis Global Minimum evalúa las N muestras sobre la superficie crítica de cada método (cada uno conserva la suya);
- un análisis Overall Slope repite toda la búsqueda N veces. Además de la distribución del factor de seguridad mínimo, registra la superficie crítica de cada muestra y la superficie probabilística crítica, que es la que tiene mayor probabilidad de rotura entre las evaluadas al menos cinco veces y no tiene por qué coincidir con la superficie crítica determinista;
- el análisis de sensibilidad se calcula como se describe más adelante.
Si hay una norma de diseño activa, a cada muestra se le aplican los coeficientes parciales igual que al modelo determinista, de modo que las estadísticas describen el factor de sobredimensionamiento (Sección 2.11). Si está activo un modo de análisis sísmico (coeficiente sísmico crítico o desplazamiento de Newmark), las estadísticas se calculan con el factor de seguridad de la superficie de menor coeficiente sísmico crítico, que no es necesariamente el menor factor de seguridad de la muestra; las notas del análisis lo señalan.
Cuando se inicia desde la ventana, el cálculo se interrumpe con un error interno (TypeError: cannot pickle 'MainWindow' object) al intentar copiar el modelo para la primera muestra, una vez terminado el análisis determinista. La ventana no muestra ningún mensaje, no se genera ninguna estadística y Show Statistics sigue en gris. El mismo análisis sí funciona con el servidor MCP (su herramienta statistics_run) y con las operaciones de la API de Python, que copian el modelo de un modo que no da ese problema (Sección 5.1, Sección 5.3).
2.10.5La ventana Statistics#
Cuando el cálculo termina correctamente, la ventana Statistics se abre sola, y Statistics → Show Statistics permite abrirla de nuevo. Elige el Method y el Plot:
- Histogram of FoS: los factores de seguridad de las muestras, con el umbral de rotura (F = 1) y la media señalados. Debajo se indican el número de muestras, la media, la desviación típica, el mínimo y el máximo, la probabilidad de rotura, el índice de fiabilidad (normal y lognormal) y el factor de seguridad determinista.
- Convergence: el factor de seguridad medio y la probabilidad de rotura en función del número de muestras. Si la cola de la curva es plana, el número de muestras es suficiente; si todavía deriva, hacen falta más.
- Sensitivity: el factor de seguridad en función de cada variable, expresada como porcentaje de su intervalo, con las variables ordenadas según la influencia que tienen sobre él.
Si en un cálculo no se han podido muestrear todas las variables (por ejemplo, porque una variable se refiere a un material que se ha eliminado después), la ventana lo indica en rojo sobre el gráfico.
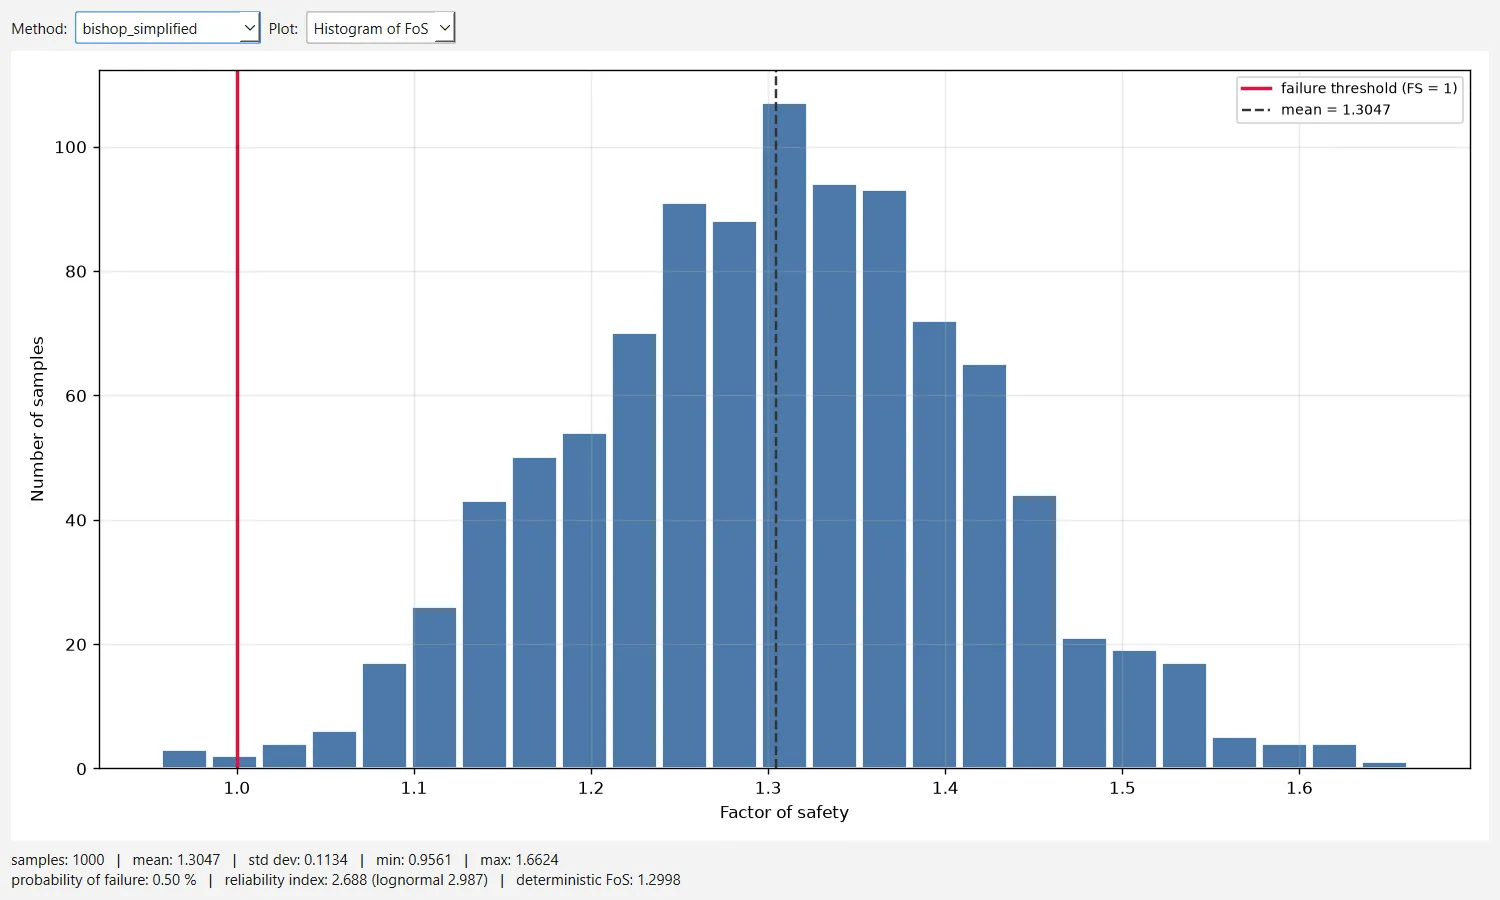
La probabilidad de rotura y los índices de fiabilidad se calculan a partir de las N muestras válidas:
donde
- número de muestras con un factor de seguridad inferior a 1
- media y desviación típica de los factores de seguridad
- media y desviación típica de sus logaritmos naturales, para el índice lognormal
2.10.6El menú Statistics de la ventana Interpret#
La ventana Interpret (Sección 2.8) tiene su propio menú Statistics. Sus tres primeros gráficos no usan las muestras probabilísticas: se trazan con los factores de seguridad de las superficies que ha analizado la búsqueda y están disponibles después de cualquier cálculo.
| Comando | Qué muestra | Necesita |
|---|---|---|
| Histogram Plot… | Histograma de los factores de seguridad de las superficies válidas de la búsqueda (25 intervalos, ajustable). | un cálculo |
| Cumulative Plot… | Distribución acumulada de los mismos factores de seguridad. | un cálculo |
| Scatter Plot… | Factor de seguridad en función del radio, para las superficies válidas de la búsqueda. | un cálculo |
| Sensitivity Plot… | Las curvas de sensibilidad del primer método. | resultados estadísticos |
| Convergence Plot… | Factor de seguridad medio y probabilidad de rotura en función del número de muestras. | resultados estadísticos |
| Export Statistics Data… | Un archivo CSV con una fila por muestra: número, valor de cada variable aleatoria y factor de seguridad. | resultados estadísticos |
| Show GM Surfaces, Pick GM Surfaces | Dibuja, o lista para elegir, todos los mínimos que contiene el resultado: la superficie crítica de cada muestra de un cálculo Overall Slope o las regiones que ha distinguido una Particle Swarm Search con varios mínimos. | cualquiera de los dos casos |
| Critical Probabilistic Surface | Muestra en la barra de estado la probabilidad de rotura y el índice de fiabilidad de la superficie probabilística crítica. | un cálculo Overall Slope |
Los comandos que necesitan resultados estadísticos aparecen en gris mientras no los haya, y un texto emergente lo indica. Show GM Surfaces y Pick GM Surfaces no los necesitan: también funcionan después de una Particle Swarm Search con Report several minima marcada, que en la versión 0.1.235 es la única manera de usarlos desde la ventana.
2.10.7Análisis de sensibilidad#
El análisis de sensibilidad toma las variables aleatorias de una en una, divide el intervalo real de cada una en tantos intervalos como indique Sensitivity intervals (50 por defecto, es decir, 51 valores) y recalcula el factor de seguridad sobre la superficie crítica de cada método para cada valor, con todas las demás variables fijas en su media. Solo se emplean el mínimo y el máximo de cada variable: la distribución, la desviación típica y las correlaciones no intervienen, y de este análisis no resulta ninguna probabilidad de rotura. El resultado indica qué datos de entrada influyen más y cuánto puede variar uno de ellos antes de que el factor de seguridad llegue a 1.
2.10.8Interpretación de los resultados#
- Comprueba el gráfico de convergencia antes de citar una probabilidad de rotura: si el valor todavía cambia al añadir muestras, hacen falta más.
- Un cálculo Global Minimum supone que la superficie crítica no cambia de una muestra a otra. Si los datos de entrada pueden cambiar el mecanismo de rotura (por ejemplo, una capa débil de resistencia variable), conviene comparar con un cálculo Overall Slope.
- El índice de fiabilidad presupone una distribución normal o lognormal del factor de seguridad. La probabilidad de rotura es la fracción de muestras con y no presupone ninguna distribución, así que con pocas muestras una probabilidad pequeña se estima con muy poca precisión.
- Una muestra que no puede evaluarse se descarta, y el cálculo indica cuántas han sido.